UC Berkeley reduz índice vetorial de 201 GB para 6 GB com LEANN
Sky Computing Lab, da UC Berkeley, apresenta o LEANN, índice vetorial open-source que quase não armazena embeddings, corta o uso de disco em até 30x e mantém a precisão em buscas semânticas locais.
Tecnologia
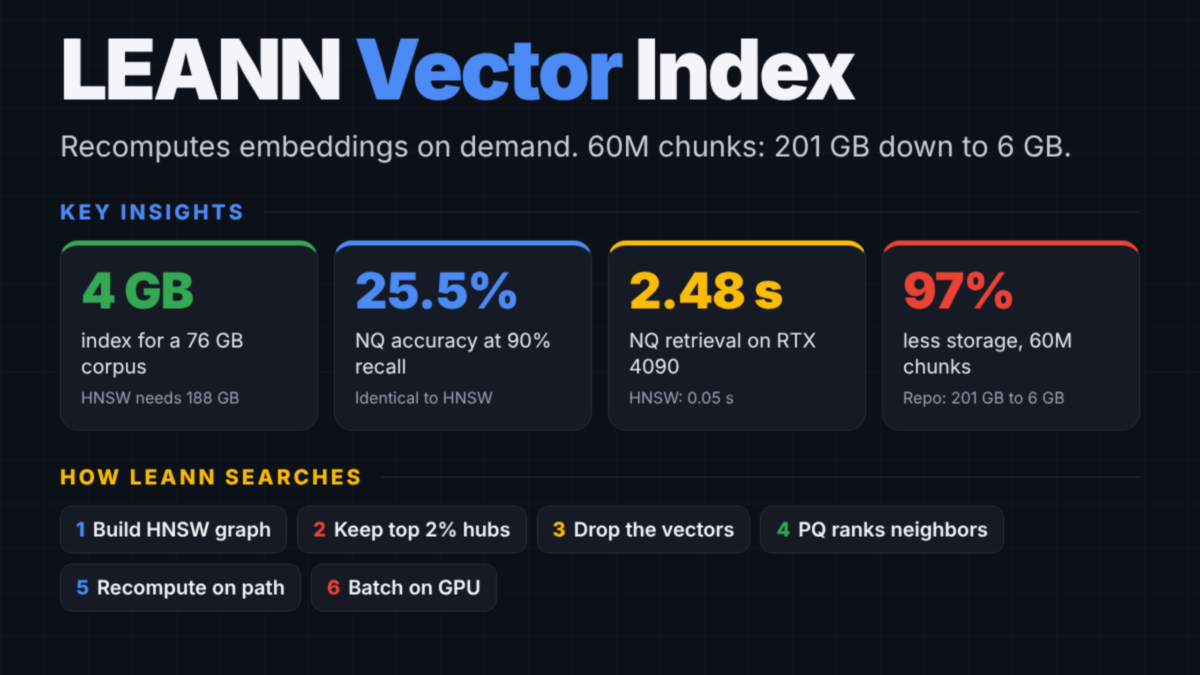
LEANN revoluciona armazenamento e busca semântica ao reduzir drasticamente o tamanho do índice vetorial.
Leia também: Bank of America alerta: nunca informe senha a assistentes de IA
O laboratório Sky Computing, da Universidade da Califórnia em Berkeley, apresentou o LEANN, um novo índice vetorial de baixo armazenamento que praticamente elimina o uso de embeddings em disco, permitindo encolher um índice de 60 milhões de trechos da Wikipédia de 201 GB para 6 GB, sem perda relevante de precisão em buscas semânticas e sistemas de RAG.
Índice joga fora os vetores e recalcula tudo na hora da busca
O LEANN é um índice de vizinhos aproximados (ANN) construído sobre o FAISS que ataca um problema conhecido: em muitos casos, o índice vetorial fica maior que o próprio corpus. Em um dos exemplos apresentados pela equipe, um conjunto de dados de 76 GB exige 173 GB de embeddings e mais 15 GB de grafo HNSW, mais que dobrando o tamanho dos dados originais.
Para mudar esse cenário, o LEANN mantém apenas um grafo podado e uma tabela compacta de quantização de produto (product quantization, PQ). Em vez de gravar todos os embeddings em disco, ele os recalcula sob demanda durante a consulta. “LEANN recomputa embeddings em tempo de consulta ao invés de armazená-los em disco”, resume a equipe de pesquisa da UC Berkeley.
Na prática, o sistema se apoia no fato de que grafos como o HNSW visitam apenas um subconjunto pequeno de nós por consulta. O LEANN armazena o grafo e a tabela de PQ, percorre um caminho reduzido no grafo e re-embeda somente os nós realmente visitados. Técnicas como busca em dois níveis e processamento em lote ajudam a acelerar o processo. Ainda assim, “a recomputação dos embeddings representa cerca de 76% da latência da consulta”, segundo a pesquisa.
Desempenho: muito menos disco, latência maior porém aceitável
Os benchmarks divulgados indicam que o ganho de armazenamento é drástico. Em um índice de 60 milhões de chunks da Wikipédia, o tamanho total cai de 201 GB para 6 GB. Em outro cenário, um índice de 400 mil mensagens de chat desce de 1,8 GB para 64 MB, enquanto 38 mil entradas de histórico de navegador encolhem de 130 MB para 6,4 MB.
Nos testes com o conjunto de perguntas NQ, o LEANN e o HNSW atingem a mesma acurácia downstream, de 25,5%. A diferença está no espaço usado: “LEANN e HNSW alcançam 25,5% de acurácia downstream no NQ, com LEANN usando 4 GB e HNSW 188 GB”, registra o trabalho. Em relação a modelos tradicionais de busca lexical, “LEANN melhora a correspondência exata em até 11,8% em relação ao BM25”, de acordo com a pesquisa.
O preço dessa economia de espaço aparece na latência. No NQ, o tempo de recuperação passa a 2,48 segundos para o LEANN, contra 0,05 segundo do HNSW, em testes com GPU RTX 4090. Em outros datasets, a latência de recuperação varia de 1,12 segundo (GPQA) a 7,12 segundos (HotpotQA). Mesmo assim, o impacto no uso real tende a ser menor, porque a geração da resposta já consome a maior parte do tempo: a pesquisa aponta que “a geração de resposta leva cerca de 20 segundos”.
Nos experimentos com tarefas de código do ContextBench e do SWE-Bench Pro, o LEANN também mostrou ganhos. O trabalho relata 24,2% de recall inicial relevante em 30 tarefas, contra 11,4% do BM25, além de 8,4% menos tokens usados pelo agente, o que reduz custo e tempo de uso de modelos de linguagem.
Entenda o contexto
Índices vetoriais são a base de buscas semânticas e de sistemas de recuperação aumentada por geração (RAG), que usam modelos de linguagem para responder a perguntas a partir de documentos, histórico de mensagens, e-mails ou código. Hoje, porém, esses índices costumam ser construídos em servidores com amplo espaço em disco, o que limita a adoção em dispositivos pessoais.
Como cada documento precisa ser convertido em um vetor denso de alta dimensão, o volume de embeddings cresce rapidamente e pode superar com folga o tamanho dos dados originais. Em cenários de uso pessoal, como organizar anos de e-mails ou chats em um notebook, isso é um gargalo de armazenamento. O LEANN tenta mudar esse padrão ao levar a lógica de recomputação dos vetores para o momento da consulta, trocando espaço por algum tempo extra de processamento.
Uso em laptops e dados pessoais
O LEANN foi desenvolvido no Sky Computing Lab, da UC Berkeley, com foco declarado em rodar bem em laptops e dispositivos pessoais, preservando a privacidade de dados sensíveis. A biblioteca é open-source, licenciada sob MIT, e pode ser instalada diretamente no ambiente Python. “O código é licenciado sob MIT e pode ser instalado com ‘pip install leann’”, informa a documentação oficial.
O repositório já traz aplicações prontas para indexar documentos locais, e-mails do Apple Mail, histórico do Chrome, conversas em apps como WeChat e iMessage, além de exportações de chats de ferramentas como ChatGPT ou Claude. Há também integração com dados ao vivo de Slack e bookmarks do Twitter, e a possibilidade de expor o LEANN como servidor de busca semântica para agentes de código.
O sistema oferece suporte a múltiplos sistemas operacionais, incluindo Ubuntu, Arch, WSL, macOS e Windows, e conecta-se a modelos de linguagem por meio de APIs compatíveis com OpenAI, Ollama, Hugging Face e Anthropic. Isso facilita o uso tanto em ambientes pessoais quanto em projetos corporativos ou acadêmicos.
Impacto e próximos passos
A pesquisa sobre o LEANN foi reconhecida com prêmio em conferência de sistemas de machine learning neste ano e repercutiu na comunidade de IA pela proposta de praticamente eliminar o armazenamento de embeddings sem derrubar a qualidade das respostas. A divulgação recente, com apoio de divulgadores como Asif Razzaq, CEO da Marktechpost AI Media Inc., deve acelerar a adoção por desenvolvedores e empresas.
A expectativa é que o índice passe a ser incorporado a produtos comerciais e a projetos open-source de busca semântica, especialmente em cenários com forte restrição de armazenamento ou exigência de privacidade, como notebooks de desenvolvedores, máquinas corporativas e dispositivos de pesquisa em campo.
Do lado técnico, um dos próximos focos deve ser reduzir ainda mais a parcela de tempo gasta na recomputação dos embeddings, hoje responsável pela maior parte da latência de consulta. Se essa otimização avançar, o modelo de índice «quase sem vetores» proposto pelo LEANN pode influenciar novos projetos na área de recuperação de informação e reconfigurar o padrão de como dados são armazenados e consultados em aplicações de inteligência artificial.