FlashMap acelera LLMs em até 6,14x sem perda de qualidade
Pesquisadores dos EUA lançam o FlashMap, novo método de decodificação especulativa que gera blocos de 16 tokens de uma vez, acelera LLMs em até 6,14 vezes e mantém a mesma qualidade de saída.
Tecnologia
Novo método de decodificação aumenta significativamente a velocidade dos LLMs sem comprometer a qualidade do resultado.
Leia também: Família acusa OpenAI por morte de engenheira guiada por chatbot
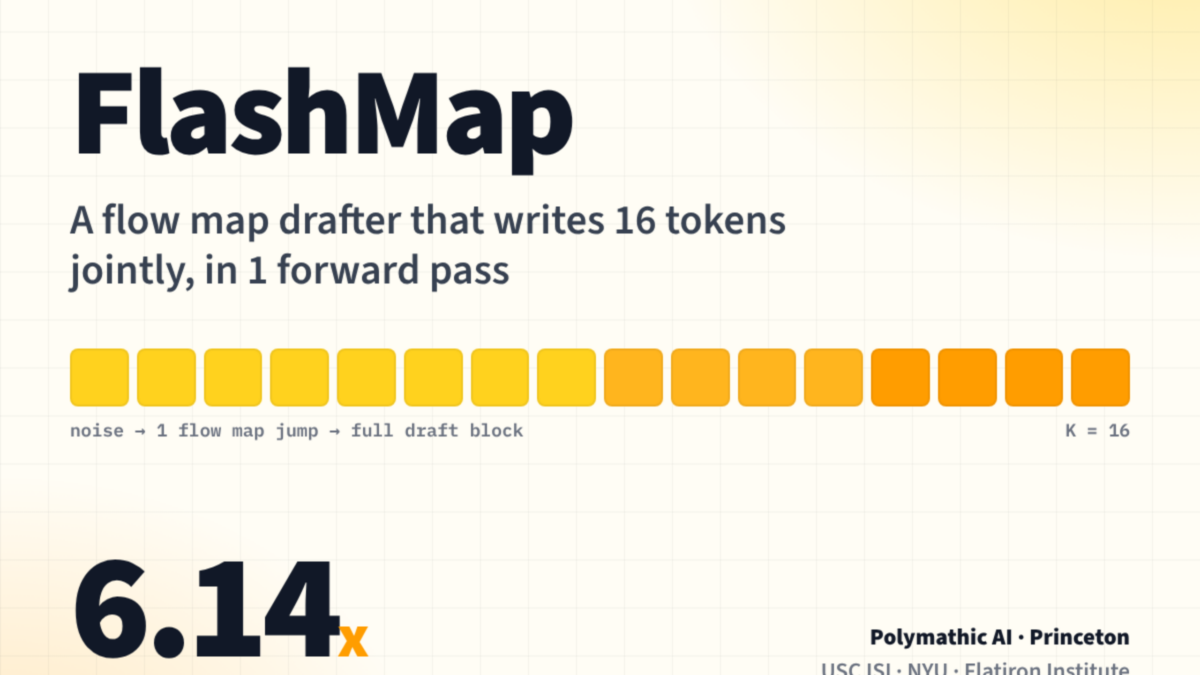
Pesquisadores de Polymathic AI, Princeton University, USC ISI, NYU e Flatiron Institute lançaram nesta semana o FlashMap, um novo drafter de decodificação especulativa que troca a difusão discreta por um mapa de fluxo contínuo para gerar blocos de 16 tokens em uma única passagem, acelerando a resposta de modelos de linguagem grandes em até 6,14 vezes sem perda de qualidade.
O que é o FlashMap e como ele acelera os modelos
O FlashMap é um componente que fica acoplado ao modelo de linguagem e assume parte do trabalho de geração do texto. Em vez de produzir cada token de forma sequencial, ele usa um mapa de fluxo contínuo que transforma ruído gaussiano diretamente em um bloco inteiro de 16 tokens, em um único passo de inferência.
Na prática, o drafter propõe K tokens de uma vez, e o modelo alvo verifica todos em paralelo, mantendo o maior prefixo que coincide com o que ele mesmo geraria token a token. Com isso, a saída final continua idêntica à do modelo original, mas chega muito mais rápido, já que boa parte dos tokens é aceita sem precisar ser recalculada.
A equipe destaca que, nesse esquema, “tokens in that block stay consistent with each other.” A diferença para métodos anteriores, que previam cada posição do bloco de forma independente, é que o FlashMap escolhe a sequência inteira de forma conjunta, evitando combinações incoerentes que seriam descartadas pelo modelo alvo.
Arquitetura do drafter e custo de treinamento
O coração do FlashMap é um transformador de difusão de 6 blocos (DiT). Segundo os pesquisadores, “the drafter is a 6-block diffusion transformer (DiT), with embedding dimension 2048 and 16 attention heads.” Ele lê estados ocultos de várias camadas internas do modelo alvo e reutiliza a matriz de embeddings e a cabeça de linguagem originais, copiadas e mantidas congeladas durante o treinamento.
Para ensinar o drafter a antecipar o comportamento do modelo principal, os cientistas treinaram o FlashMap com 500 mil amostras do conjunto Open-PerfectBlend. “Total compute across all models and ablations was about 4,600 GPU hours on H200s”, afirma a equipe, indicando o volume de recursos de hardware dedicado à pesquisa.
Quão rápido é o FlashMap?
Nos testes divulgados, o FlashMap atinge aceleração de até 6,14 vezes na decodificação lossless — isto é, sem alterar a resposta final — ao rodar o modelo Qwen3-8B na tarefa matemática GSM8K. “On Qwen3-8B, the research team reports up to 6.14x lossless speedup on GSM8K”, resume o grupo.
Para comparar, os pesquisadores reentreinaram métodos concorrentes, como EAGLE-3 e DFlash, com os mesmos dados e configurações, e avaliaram todos em nove benchmarks que incluem tarefas de matemática, geração de código e chat, em temperaturas 0 e 1. O objetivo foi medir ganho de velocidade mantendo a qualidade das respostas.
Experimentos adicionais investigam como o drafter captura relações entre tokens. “A shuffle test checks whether drafts use real inter-token structure”, explicam os autores. Com dois passos de fluxo, o FlashMap recupera a maior parte da estrutura conjunta que um professor em 16 passos conseguiria; com apenas um passo, retém só uma fração desse ganho.
Ganho extra com amostragem em árvore
Os testes também mostram que variar o ruído inicial de forma estruturada ajuda a acelerar ainda mais. “Drafting 4 noise samples as a tree raised speedup by 11% on average”, relatam os pesquisadores. Nesse esquema, o drafter gera diferentes blocos candidatos a partir de quatro amostras de ruído, organizadas como uma árvore de possibilidades, aumentando as chances de o modelo alvo aceitar blocos maiores de uma vez.
Como usar o FlashMap em prática
O pacote do FlashMap já está disponível em código aberto, com implementações, pesos de modelos e plugins para integração em servidores de inferência. Os drafters treinados para Qwen3-8B e Qwen3-4B podem ser baixados em repositórios públicos no Hugging Face e no GitHub.
A implementação foi pensada para encaixar em ferramentas já usadas no dia a dia de desenvolvedores. “The flashmap package needs only torch and transformers>=4.56”, informa a equipe. A instalação pode ser feita via pip, e uma única GPU é suficiente para rodar drafter e modelo alvo juntos em chamadas como spec_generate.
Para uso em produção, os autores recomendam ajustar o número de passos de fluxo do drafter, o que influencia a taxa de aceitação dos blocos propostos. “Set num_steps=2 to trade some speed for higher acceptance”, sugerem. Para cenários com temperatura acima de zero, a integração com servidores como o vLLM deve usar o modo probabilístico de amostragem para respeitar as distribuições de saída do modelo.
Entenda o contexto
A decodificação especulativa surgiu como resposta ao gargalo da geração token a token em LLMs, que limita a velocidade de chatbots, ferramentas de código e sistemas de análise de texto. A ideia central é usar um modelo auxiliar mais leve — o drafter — para “adiantar” blocos de tokens, que são depois confirmados ou corrigidos pelo modelo mais pesado.
Métodos anteriores, porém, esbarravam em dois problemas: custo de gerar blocos cada vez maiores e inconsistências internas nas sequências previstas, o que levava o modelo alvo a rejeitar muitos tokens e anulava boa parte do ganho de desempenho. Ao substituir a difusão discreta por um mapa de fluxo contínuo e garantir coerência dentro de cada bloco, o FlashMap tenta resolver esses gargalos de uma vez.
Impacto para empresas e desenvolvedores
Para quem mantém aplicações em cima de LLMs — de assistentes virtuais a sistemas de suporte a código e soluções para problemas matemáticos —, a promessa do FlashMap é reduzir latência e custo computacional, permitindo servir mais requisições com a mesma infraestrutura de GPU. Em cenários de alto tráfego, um ganho de 6,14 vezes na decodificação pode significar menos filas de espera e respostas mais fluídas para o usuário final.
Como o pacote é compatível com frameworks amplamente adotados e roda em uma única GPU, a tecnologia também se torna acessível para startups e grupos de pesquisa menores, não só para grandes laboratórios. Por outro lado, ferramentas que continuarem presas a métodos tradicionais de decodificação tendem a perder competitividade à medida que soluções mais eficientes como o FlashMap forem adotadas pela comunidade.
Com código, pesos e documentação públicos, os autores convidam a comunidade a experimentar, testar em novos modelos e propor melhorias. A expectativa é que o método seja adaptado para diferentes arquiteturas e frameworks, avance para otimizações de produção e acabe se tornando peça padrão em pipelines de decodificação especulativa nos próximos ciclos de inovação em IA generativa.